英伟达首席执行官黄仁勋在柏林GTC大会上密集发布新品,覆盖AI基础设施、智能体安全、机器人与自动驾驶等多个领域,并向欧洲政商界发出强烈呼吁——所有行业都必须成为AI公司。
10月21日,英伟达首席执行官黄仁勋在GTC大会上表示,未来所有电信运营商都将提供AI算力,电信基站有望演变为分布式AI网络。他将AI经济描述为由能源、算力、AI工厂、模型与应用构成的五层结构,并在展示中突出指出,算力层仅出现英伟达一家公司的标志。
此次发布涵盖模块化AI数据中心产品DSX Pod、智能体安全架构OpenShell、人形机器人参考平台,以及涉及自动驾驶、癌症治疗和蛋白质设计等多个垂直领域的新品与合作。英伟达在活动中还宣布,过去一年已在欧洲投资近100亿美元,建立超过12000项合作关系。演讲期间一度被绿色和平组织抗议人士打断,黄仁勋称将事后与其沟通,随即继续演讲。
在当前部分投资者对AI基础设施投入规模日益质疑的背景下,黄仁勋发出明确看多信号。"欧洲要想从AI中受益,并真正建立起AI生态和AI经济,就需要所有终端市场、终端行业都采用AI,"他在演讲中表示,并点名汽车、金融服务和医疗保健行业。英伟达美股盘前一度涨逾2%。
DSX POD:将部署周期从六个月压至14天
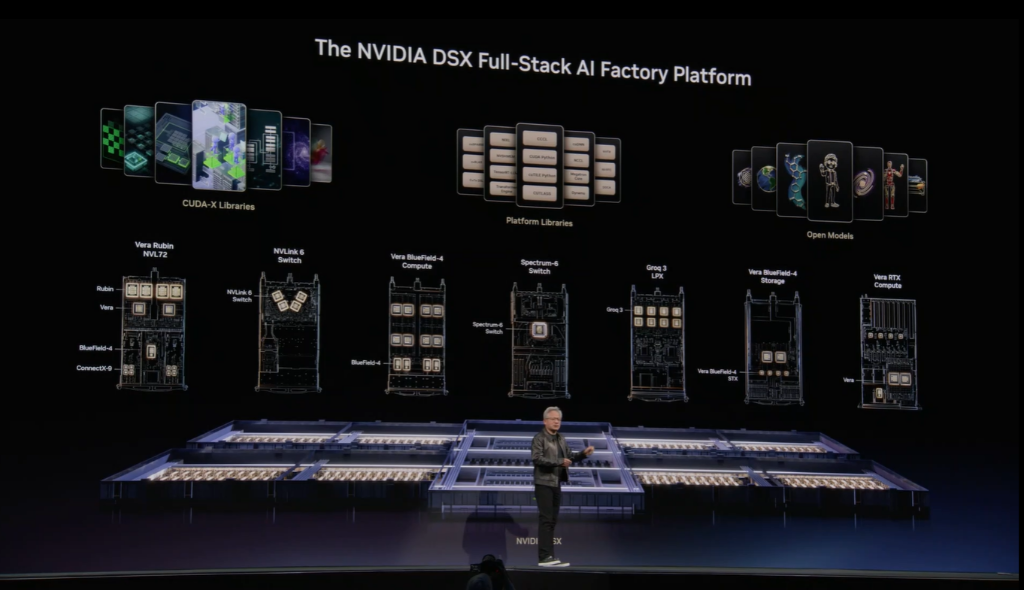
英伟达发布的DSX POD是基于Vera Rubin架构的完整AI工厂参考设计。其核心逻辑在于,将计算、网络、布线、机架级供电及液冷系统的集成安装工作,从现场施工转移至制造工厂。合作伙伴在发货前完成机架间线缆连接、电气布线、管道安装和功能验证,集装箱运抵现场后只需接入预先准备好的电力、冷却与网络设施,即可投入使用。
黄仁勋表示:
"AI工厂在开始生产token时创造价值,而不是在建设完工时。借助DSX POD,我们将工厂级精度和速度带入AI基础设施建设,把部署时间从数月缩短至数周,使客户能够更快扩展容量并让可创收的生产上线。"
需要指出的是,14天指的是场地已完成准备情况下的现场部署时间,不包含从选址到建成的完整周期。客户仍需提前完成电力、冷却、网络等支持设施的准备工作。英伟达计划与戴尔科技、HPE、联想、Bull、施耐德电气、维谛技术等合作伙伴,于2027年初在全球交付基于DSX POD设计的模块化AI工厂。
在能效层面,DSX AI工厂平台采用闭环液冷和干式冷却器,将冷却用水量降至接近零,在2吉瓦规模下每天可节省高达5400万升水;DSX MaxLPS软件则可帮助运营商在相同token输出下减少最多30%的功耗。
OpenShell:以硬件级隔离管控AI智能体行为
随着智能体部署规模扩大,英伟达推出OpenShell参考架构,专门应对智能体安全问题。该架构整合Vera Rubin基础设施、Vera CPU、BlueField-4数据处理器,以及OpenShell安全运行时软件,通过在系统调用、文件访问和网络连接粒度上执行策略,限制智能体可访问的资源范围。
核心机制是运行在BlueField-4上的NVIDIA Sentry安全框架,该框架在硬件隔离的可信域中持续监控智能体行为,一旦检测到异常操作,可在毫秒级将其隔离并切断其与模型的连接。英伟达称,Vera Rubin NVL72系统在智能体工作负载下的每兆瓦吞吐量可达此前的30倍,NVIDIA Sentry则可将智能体承载能力提升最多20%。
OpenShell采用Apache 2.0许可证开源,支持Linux、Kubernetes、微软Windows等企业环境,并可扩展至边缘设备。微软、谷歌云、戴尔科技、思科、OpenAI、Anthropic等已宣布参与相关合作,其中Anthropic与英伟达正合作开发Claude OpenShell智能体。
机器人与自动驾驶:多家欧洲车企及机器人公司加入生态
在物理AI领域,英伟达披露,今年上半年相关市场营收同比增长约30%,至约110亿美元。
在机器人方向,英伟达宣布扩展Isaac开放机器人开发平台,推出开源运行时框架Isaac OS、机器人学习框架Isaac Lab 3.0,以及包含2000余种仿真就绪机器人和工厂资产的SimReady Central Library。同时,英伟达与思灵机器人合作推出人形机器人参考平台Agile One SN,内置Jetson Thor计算硬件,预计明年第一季度上市。黄仁勋表示:
"通用机器人正以惊人的速度进步——机器人的ChatGPT时刻正快速临近。"
在自动驾驶领域,沃尔沃汽车将采用英伟达Hyperion计算平台及Alpamayo自动驾驶软件栈开发自动驾驶汽车;大众将英伟达产品用于商用车;Bolt Technology则基于英伟达软件及硬件推进Robotaxi业务,计划2027年起在马德里采集真实驾驶数据,并规划在欧洲部署至少2.5万辆具备L4自动驾驶能力的车辆。此外,梅赛德斯-奔驰将利用Hyperion平台开发L3和L4级自动驾驶能力。英伟达还推出Halos SAFE安全评估框架,将仿真、软硬件在环测试、道路测试和车队监测纳入统一评估流程。
医疗与生物医药:从放射治疗到蛋白质设计
英伟达在医疗健康领域宣布多项合作。与西门子医疗旗下癌症治疗业务合作,探索将智能体AI、患者个体化仿真及实时计算应用于自适应放射治疗,相关系统将实时监测患者呼吸与体位变化并动态调整放射剂量。
在生物医药方向,英伟达与华盛顿大学医学院蛋白质设计研究所合作推出开放模型BioNeMo RFD4-Proteina,可根据分子输入、设计约束和评分目标生成并优化蛋白质设计方案,应用场景涵盖药物研发、疾病检测及工业酶开发。
开放模型与基础设施:布局欧洲本土AI生态
面向欧洲企业和研究机构,英伟达宣布扩充开放模型产品组合,新品涵盖Nemotron 3.5系列语言与视觉模型、面向结构化商业数据分析的Kumo模型、用于机器人训练与仿真的Cosmos世界模型、面向自动驾驶边缘推理的Alpamayo 2 Edge,以及用于量子计算的Ising模型。
黄仁勋将AI经济比作由能源、算力、AI工厂、模型与应用五层构成的结构,并指出欧洲AI基础设施建设正在加速。他预测,未来所有电信运营商都将提供AI算力,现有电信基站有望逐步演变为分布式AI网络。在合作伙伴层面,Nscale、Firebird等AI数据中心建设商,以及Mistral、Legora、DeepL等欧洲AI模型与应用公司,均被纳入其展示的AI经济生态图谱。
以下为黄仁勋在英伟达2026年柏林GTC主题演讲全文:
黄仁勋:
2020年,我们开始与梅赛德斯-奔驰合作开发自动驾驶汽车。回顾英伟达33年的发展历程,我在德国度过了很多时间。因此,我很高兴再次来到这里,也很高兴今年能在这里举办GTC。
过去一年,我们开启了一段新的旅程:在欧洲建设一个新产业,推动AI经济起步。
仅在过去一年,我们就在欧洲投资了近100亿美元,涵盖初创企业,以及遍布欧洲的大大小小的合作项目。
就在过去一周,我从法国、英国来到瑞典,再来到柏林。期间,我们宣布投资了14家初创企业。迄今为止,我们在欧洲建立了超过12,000项合作关系,大家都在朝着同一个目标努力。
计算机产业经过数十年的发展,如今,我们正站在一场新工业革命的起点。
这张图片是计算机生成的,提示词由我提供。我只是简单描述了“AI推动新工业革命”,再列出几家希望突出展示的合作伙伴,它就生成了这幅画面。
非常有意思的是,在AI的理解中,建设一个新产业,意味着生成Token、生产智能,再把智能融入每一个行业,推动新的工业革命。
当一项新技术改变了我们如何制造产品,以及我们能够制造什么产品时,一场新的工业革命就会发生。
我认为,人工智能将在各个方面影响我们制造的一切,并让我们能够创造过去无法创造的新事物。
每个人都会使用它,每家公司都会由它赋能,因为它是数字智能,是一切的基础。每个行业都会因此改变,新的行业也会诞生。
就像电力一样,AI将带来一场新的工业革命,而我们才刚刚起步。
问题是:什么是AI?
如果你希望参与创造这个未来,理解AI究竟是什么,至关重要。
我们很早就意识到,AI实际上是一个制造产业。
它不仅是一项软件技术。AI当然运行在计算机上,但这种计算机的运行方式已经发生了根本变化。它不再仅仅是供我们使用的工具,而是成为机器、基础设施和工厂的一部分,用来生产智能,再将智能融入每一个行业和应用。
一个简单的理解方式,是把AI看作一块五层蛋糕:
能源驱动先进计算机;这些计算机构成AI工厂;运行在工厂中的模型生成Token,也就是数字智能;这些智能再融入各种应用。
要参与AI经济,你不应该只消费AI,也应该生产AI。这些事情,我们都可以在欧洲完成,而且已经开始了。
欧洲正在建设自己的AI经济,图中展示的就是这五个层次。我们拥有出色的合作伙伴。观察这五层结构,你会发现,这确实是一个新产业,因为每一层都在增长。
我们正在以惊人的速度创造就业和增长机会。欧洲的施耐德电气、西门子、西门子能源等公司,在全球都有出色表现。
英伟达处于计算层,我们的技术被集成到欧洲各地不断涌现的AI工厂中。Nebius等新兴企业发展得非常好;一家名为Firebird的新公司正在中亚地区建设新的云平台,非洲也有Cassava这样的企业。
我预测,未来每一家电信运营商都会向AI转型。大量通信站点及数据中心构成的分布式基础设施,将演变为分布式AI网络。原稿所述规模为约10万个站点、约100吉瓦。
AI基础设施正在建设,其上才是AI模型。
必须认识到,在模型出现之前,基础设施就必须先存在。就像拥有互联网之前必须先建立网络,要享受电力的能力,必须先建设电厂、让住宅接入电网一样。
模型层也不只有语言模型,还包括生物、化学、物理、机器人动作和动画等模型,而且规模各不相同。
不同产业将由不同模态的AI模型驱动。这些模型进一步融入AI原生企业和初创公司,而欧洲有大量这样的企业。
欧洲的AI经济已经起步,而且正在加速发展。
谈到英伟达在底层的贡献,多数人首先想到的是GPU,这当然没错。
1993年,我们从图形芯片起步,后来发展出GPU和可编程着色GPU。随后,我们加入CUDA加速能力,重新定义了计算,并推动了人工智能的发展。
但今天的英伟达,实际上已经是一个覆盖全栈、端到端的完整AI工厂平台。多年来,我们的技术范围已经大幅扩展。
我们的技术包括GPU计算,最新一代是Vera Rubin;包括将多颗GPU连接成一颗巨大GPU的NVLink交换机;包括最近推出的Vera和BlueField-4,稍后我还会介绍。
还有我们的以太网解决方案Spectrum-X,它使英伟达成为如今全球最大的网络公司。
还有用于文本及Token生成的解码加速器Groq 3。
此外,还有基于Vera和BlueField-4的存储加速,以及Vera RTX计算。稍后我会分别介绍。
这些技术共同构成了建设AI工厂所需要的硬件体系,但如果没有软件将其激活,一切都无法工作。
首先是运行AI工厂的系统软件。
这些系统极其庞大。一座1吉瓦的数据中心,也就是一座1吉瓦的AI工厂,成本大约为500亿美元。这包括土地、电力、建筑,以及计算、网络、存储、供电和冷却设备。
所有设备连接起来,形成占地数英亩的AI工厂。仅仅让它启动并正常运行,本身就是一项壮举。
让这座工厂运转、投入使用并生产Token,需要海量软件,这是一项非凡的工程。英伟达提供完整的全栈软件。
其上是我们称为CUDA-X的库,也就是英伟达的算法体系。
从本质上说,英伟达是一家算法公司,我们设计芯片来加速这些算法。
其中之一是cuDNN。很多研究人员认为,这个库推动了现代AI的大爆发。
cuDNN之于AI,就像SQL之于全球数据库产业。它是面向特定领域的语言和库。
就像OpenGL和DirectX推动了实时计算机图形的发展,cuDNN推动了AI计算产业的发展。
除此之外,我们还有350个其他库。这些库才是公司的核心资产,覆盖计算光刻、信号处理、图像处理、数据处理、粒子、流体、稀疏求解器等广泛领域。
在座许多人的公司已经接入了这些库。
我们通过这种方式开拓新市场,将英伟达与各种算法连接起来,让大家以极高速度完成计算。
最右边则是模型。
模型是新的软件,也是新应用的引擎。它们建立在CUDA-X库之上,并与这些库协同工作。
英伟达一直在多个领域开发这些模型,它们将开启新的机会,稍后我会详细介绍。
回顾AI时代的各代产品,我们从Pascal开始。
基于Pascal的DGX-1,是世界上第一台AI超级计算机。我在十年前发布它,并将第一台交付给OpenAI,开启了他们的计算发展历程。
从Pascal到Volta、Ampere,再到很多人第一次听说英伟达时接触到的Hopper,然后是当前的Blackwell,以及如今已全面投产的Vera Rubin。
这是六代架构。每一代,我们都在推动技术进步。
过去十年,我们将AI性能提高了100万倍。
退一步想,如果只依靠摩尔定律,十年会发生什么?前五年提高10倍,后五年再提高10倍,合计约100倍。
而在同一时期,我们通过所谓的“极致协同设计”,同时在计算机架构和软件栈各层开展创新,优化算法、创造新算法,并设计相应架构来加速它们,最终将AI性能提高了100万倍。我们还会继续这样做。
这就是今天英伟达所构建的技术体系,也是我们帮助欧洲参与AI生态和AI经济的基础。
早期的Pascal、Volta、Ampere和Hopper,主要围绕GPU展开。我们创造了新的DGX形态。
到了Blackwell,我们向世界推出了首个机架级计算系统。
机架级计算把一整套系统变成一台巨大的计算机,或者说一颗巨大的GPU。
到了Vera Rubin,我们进一步扩展计算范围:不再只处理模型或大语言模型,而是处理整个智能体。
稍后我们还会回到这张图,但请记住:智能体需要思考,而模型承担的就是这部分工作。
感知、推理、规划和工具使用,都依赖大语言模型,模型也是为这些能力而设计的。
但智能体还需要一个运行框架,也就是Harness。你可以把它理解为数字智能体的外骨骼。
就像人有大脑,也有身体,智能体框架负责协调工作,让智能体能够调用记忆,包括活动记忆、工作记忆和长期记忆,并使用工具。
第三部分是处理知识的计算机,专门负责数据处理。
最后,还有一类专门运行CUDA-X库的计算机,负责执行工具。
这些计算机共同构成完整的智能体系统。
Vera Rubin已经全面投产。我们来看看实物。
这是我们打造的第一款没有外露连接线缆、采用100%液冷设计的计算机。它可以直接抽出来,非常方便。
这就是一台Vera Rubin计算机,这个单元有两颗GPU。
过去,组装一个Grace Blackwell节点需要两个小时。你看过实物就会明白,到处都是线缆,它采用约80%的液冷设计。
现在,Vera Rubin实现了100%液冷,组装时间不到五分钟。
这是了不起的进步,意味着更短的制造周期、更高的可靠性,以及更好的性能。
这是NVLink交换机托盘。它将72颗GPU连接起来,形成一颗巨大的GPU。
每颗GPU的性能为20 PFLOPS,再将72颗连接成一个庞大的系统。
这是我们的新款Vera计算机。
[现场出现插话]
没关系,温和一点,让她有机会说话。每个人都有表达的机会。不过今天,先让我完成演讲,我稍后会和你们交流。
这些都是重要的问题,但请让我先讲完主题演讲。
这个会场已经坐满,全球还有100个同步观看活动,现在有15,000人正在观看。
最后我准备了一些非常有意思的内容。在娱乐环节到来之前,大家得先忍受一下我的知识讲解。
这是全新的Vera计算机。Vera CPU是一颗非常强大的处理器,每个时钟周期能够执行八条指令。
它采用了我们所说的全球首创LPDDR内存子系统,兼具高性能、极高带宽和出色的能源效率。
它的片上互连速度在全球芯片中处于领先水平,因此,数据处理,以及智能体会话的启动和执行性能,都非常出色。这正是它的设计目标。
这就是Vera计算机。
旁边这套是Spectrum-X,采用共封装光学,也就是CPO技术。我给大家看看。
舞台上有些地方是空的,有些地方可以踩,我不太确定分别在哪里。如果我突然消失了,大家要知道,那不是特技,是意外。
这里是激光器。光信号通过光学连接直接进入芯片。
我们与台积电共同开发了一项名为COUPE的工艺,让硅光子器件能够直接连接到芯片上。
否则,这一整块区域都需要通过印刷电路板传输信号,而电路板的传输能力远不如光纤。
现在,我们可以让极高数据速率、高质量的信号直接到达芯片,减少传统方案中通过电路板和收发器进行转换的环节。
这是我们的CPO产品,已经进入全面量产,提供512个端口,每个端口的速率为200Gbps。
这是全球最先进的以太网交换机,我们对此非常自豪。
这些系统让我们能够处理大语言模型的思考过程,运行智能体框架,处理智能体所需的知识数据,并通过加速计算运行各种工具。这些基本上构成了智能体的完整工作负载。
Vera Rubin已经全面投产,性能非常出色。
正如我所说,每一代产品,我们都通过极致协同设计,实现远超摩尔定律所能带来的性能进步。
大家知道,摩尔定律在很大程度上已经走到尽头。因此,我们需要从芯片到系统、从系统软件到算法,再到整个AI工厂,开展这种协同设计。
Vera Rubin在Blackwell的基础上又迈出了一大步。
在大语言模型处理方面,Blackwell的性能约为Hopper的30倍。而仅仅两年后,Vera Rubin又达到了Blackwell的约30倍。
接下来看看,Vera Rubin如何构成DSX全栈AI工厂。
视频旁白:
AI正在推动历史上规模最大的基础设施建设。
工厂规模庞大,投资金额巨大,我们必须把它建好。但只有优秀的芯片,还不足以构成优秀的AI工厂。
NVIDIA DSX是与全球领先基础设施企业共同开发的全栈AI工厂参考架构。
计算、网络、存储、软件、供电和冷却作为一个整体协同设计,从设计阶段到实际运营全面优化。
DSX从数字孪生开始。
在施工之前,先在虚拟环境中验证性能、功耗、用水量及扩展能力。
PTC将设备设计转化为可用于仿真的资产。
达索系统通过基于模型的系统工程,将机架设计与设施设计连接起来。
施耐德电气模拟配电和液冷系统。
Jacobs将这些内容整合进Omniverse数字孪生。
西门子评估热、声学及电网影响。
Procore支持施工阶段的规划。
电力决定AI工厂能够生产多少智能。
DSX Max LPS是一套端到端控制回路,能够根据工作负载需求动态分配电力,在实现相同产出的情况下减少30%的用电量。
DSX也重新设计了冷却方式。
NVIDIA Vera Rubin系统采用闭式液冷,在适宜气候条件下,冷却液温度可以高达45摄氏度。室外干式冷却器将热量释放到空气中,不需要蒸发水。
对于一座2吉瓦的设施,DSX每天可以节省5,400万升水,相当于18万户家庭的日用水量。
然而,建设AI工厂可能需要数月时间。在投运之前,它不会生产任何Token。
今天,我们发布NVIDIA DSX Pod,将这一全栈平台整合成在工厂内制造的一体化系统。
它以Vera Rubin NVL72为基础。
七个液冷计算机架,通过17公里的Spectrum-X线缆连接,构成一个Vera Rubin DSX Pod。
整个Pod在工厂完成集成、布线和测试,再装入可运输的集装箱交付。
干式冷却器取代传统蒸发冷却系统,800伏直流电直接连接机架,提高供电效率。
只要现场基础设施就绪,预计现场部署时间就能从数月缩短至数天。
NVIDIA DSX AI工厂从设计阶段就考虑资源效率和责任。现在有了DSX Pod,AI工厂的建设速度将大幅提升:每瓦电力产生更多智能,从交付到生成首个Token所需的时间也更短。
黄仁勋:
大家觉得怎么样?
2016年,我们发布了世界上第一台AI超级计算机。当时,它是一台单节点GPU系统。
三年前,我们推出了Grace Blackwell NVLink 72机架级计算机。
这两次创新,我们不仅重新设计了计算机、软件和运行方式,也重新设计了供应链。
以NVLink 72为例,过去整个机架需要在现场组装,现在我们把组装工作移到了供应链内部。
本质上,我们实现了超级计算机的规模化制造。
这正是我们能够如此快速行动,同时支持全球数百个数据中心建设项目的原因。
如今,全球所有主要计算机制造商都在制造NVLink 72。我们生产计算系统的规模,是过去从未有过、难以想象的。
即便如此,当这些系统运抵现场后,仍然需要数月时间进行组装。
刚才大家听到了,仅用于横向扩展计算的Spectrum-X连接,就需要17公里线缆。
假设我们把这些工作全部放到供应链内部完成:组装系统、启动运行、验证完整功能、完成质量认证和老化测试,确保出货时已经能够正常工作。
这样,现场布线和组装量就会大幅减少。
但更重要的是,数据中心里等待安装调试、无法投入使用的闲置算力,也会显著减少。
记住,每座1吉瓦数据中心的成本约为500亿美元,预期每年可创造数百亿美元收入。
假设这套基础设施每年能够创造400亿美元收入,仅仅延迟三个月,就意味着100亿美元收入推迟实现。这足以让任何人感到焦虑。
通过将这些工作转移到供应链内部,从计算设备到货、安装,到正式生产Token的时间,有望从四五个月缩短至大约一个月。
这将彻底改变全球供应链,也会改变人们安装和建设数据中心的方式。
我们希望,这能提高建设和投运速度,减少闲置算力及闲置资本支出的浪费,让所有参与者获得更好的盈利能力。
这就是将NVLink 72进一步集成为大型机柜系统的DSX Pod,也是英伟达计算系统发展的下一步。
你制造什么,以及如何制造,决定了你的独特之处。
就像欧洲企业,你们掌握的专业能力让你们与众不同:你们设计机器、运营工厂、发现药物,拥有非凡的工艺和专业知识。
英伟达的独特之处主要有两点。
第一,我们的架构是一种通用加速计算架构。
我们不只针对一种算法,例如Transformer,而是支持各种可以并行处理的工作负载,包括流体、粒子、量子计算、量子化学、图像处理、数据处理,以及结构化数据和向量数据处理。
由于我们长期投入,而且架构在过去约25年里保持一致,我们支持和加速的算法、领域及行业数量持续增长。
庞大的装机基础、通用架构、长期投入,以及与各行业的合作,让英伟达架构几乎无处不在。
第二,是我们的实现方式。
我们不仅开发架构,还将其构建成完整的全栈AI工厂。
世界上有不少公司希望自行设计芯片,但绝大多数公司只是希望部署AI基础设施,然后在其上运行自己的业务。
设计芯片、制造超级计算机、编写全部软件,对大多数企业来说都不是它们打算承担的工作。
因此,CUDA与全栈AI工厂的结合,使我们能够服务过去难以触及的市场。这也是我们能够与这里众多企业合作的原因。
从云服务提供商,也就是CSP开始,多数人认为今天绝大部分AI都集中在那里。但在演讲开头,我提到的很多公司并不属于传统CSP。
CSP仍然是全球计算市场的重要组成部分,但与此同时,世界各地正在涌现AI原生企业。
还有新型AI云服务商,也就是Neocloud。每个地区都希望参与AI经济,希望将自身拥有的宝贵资源和能源用于支持本地区企业。
例如法国的Mistral、欧洲的Nebius,以及欧洲各地建设新型AI云的公司。
还有为全球企业制造计算机的OEM和ODM厂商,以及AI实验室。
去年,我们大量讨论OpenAI;如今,除了OpenAI和Anthropic,还有Meta、Grok、Gemini等参与者,越来越多AI实验室正在推动前沿技术发展。
但最重要的是,如果AI要真正成功,如果欧洲要从AI中受益并建立完整的AI生态和AI经济,那么所有终端行业都必须采用AI,并通过AI取得成功。
无论是开发自动驾驶汽车的汽车行业、使用机器人进行制造的工业企业、通过AI发现新药的医疗行业,还是金融服务业,每个行业的企业都需要成为AI公司。
借助CUDA以及我们的计算机制造方式,我们能够服务AI的各个细分领域。
一种架构,覆盖多个市场。
这些基础设施规模巨大、成本高昂,因此必须尽快发挥最大生产力,而且能够灵活用于各种工作负载。
从AI旅程最初的数据处理,到训练、后训练、推理和智能体处理;从化学、物理到语言;从各个行业到它们使用的各种算法,都应当由同一套基础设施支持。
因此,英伟达架构具有很强的通用性和可调配性。
持续创新、持续软件更新,以及庞大装机基础所形成的丰富软件生态,又让这套架构具有长期使用价值。
通用、耐用、高效,这就是基础。
有了这些基础设施,我们能做什么?
过去一年,AI发生了转变,开始真正创造生产力。
其中一个重要时刻,是年初我们谈到OpenClaw,它将开源智能体的概念带给了更多人,也推动了如今全球正在发生的变化。
智能体会思考、推理、迭代和使用工具,因此会消耗大量Token。但也正因如此,它们开始真正有用。
更多智能体被开发出来,因为更有用,所以更多人使用;又因为思考需要大量Token,Token消耗迅速增长,GPU需求也随之大幅上升。
这张图展示的是一个智能体的五个组成部分。
第一是语言模型。模型运行在GPU上,生成供智能体使用的Token。
第二是我所说的“外骨骼”,也就是智能体框架,例如OpenClaw。
框架运行在沙箱内,沙箱将它与系统其他部分隔离。这是一个非常重要的概念。
另外两个部分是知识和工具。
模型、框架、沙箱、知识和工具,构成了智能体的五个要素。
在讨论如何让智能体变得有用之前,首先必须确保它是安全的。
智能体是自主系统,可以访问文件、资源、网络和工具。因此,我们必须赋予它最小必要权限,并持续监控其行为。
为此,我们推出了一个新平台:OpenShell。
OpenShell是一个安全运行时,提供刚才提到的能力,并可以配合额外的硬件监控机制。
在详细解释之前,我们先看一段视频。
视频旁白:
企业正在准备部署数十亿个AI智能体。
为了发挥作用,它们需要推理、规划、使用工具、访问数据并相互协作。
但如今,阻止智能体滥用这些能力的方式,往往只是告诉它:
“请不要删除任何东西。”
“请不要向主分支推送代码。”
“请不要碰我的SSH密钥。”这就是“请不要”的安全方式。
但希望不等于安全。安全不是愿望,而是技术和工程。
NVIDIA OpenShell和Sentry将这一理念落实到实际系统中。
你为每个智能体编写策略,规定它可以接触什么。OpenShell在系统调用、文件访问和网络连接层面执行这些策略。
形式化验证会检查每一次策略变更,确保其不突破你设定的权限上限,使智能体不会获得超出预期的访问权限。
这类似于早期互联网:在浏览器严格限制网页能力之前,病毒曾经四处传播。OpenShell为智能体建立类似的边界。
这些限制在智能体之外执行,而不是只依赖大语言模型内部的护栏,从而将智能体原生安全能力引入基础设施。
每个智能体都运行在自己的隔离沙箱中,不能直接访问网络。
所有出站网络请求,都必须经过沙箱外的监督组件。监督组件根据策略检查请求,未获允许的操作会被拒绝。
密钥保存在沙箱外,由监督组件管理,只有向获准访问的端点发送请求时才会加入。即使智能体遭到入侵,也无法泄露它从未持有的密钥。
网关充当控制平面,监督组件负责作出决定,沙箱容纳智能体,策略证明器则检查拟议策略是否符合权限上限。
OpenShell将Linux内核隔离与运行时策略执行相结合。
NVIDIA Sentry还可以在主机之外、远离智能体的位置,增加一层可选保护。
Sentry运行在NVIDIA BlueField-4上,在硬件隔离的信任域中监控智能体活动并执行安全策略。
智能体的推理流量经过Sentry,因此一旦检测到需要阻止的计划,系统可以立即更新策略,切断智能体与模型的连接,在毫秒内完成隔离。
它还保留可验证、防篡改痕迹的记录,供运营人员进行检测、调查和响应。
OpenShell采用Apache 2.0许可证开源,可运行在智能体所在的各种环境中,从边缘到云端。只需两个命令即可开始使用:安装命令行工具,创建沙箱,然后运行你喜欢的智能体。
智能体能发挥多大作用,取决于你赋予它多少访问能力。OpenShell和Sentry让这些访问能力处于你的控制之下。
这就是我们同时推进AI能力与安全的方式。
黄仁勋:
智能体是自主系统。我们必须创造高度安全的技术,确保能够安全地开发和部署它们。
OpenShell发布后,从前沿模型实验室,到操作系统公司、网络安全公司和平台公司,许多大型企业都开始采用它。
因为这项技术到来的时机恰到好处:我们正准备在全球大规模部署智能体。
这不仅关乎服务提供商在部署智能体时使用OpenShell,也关乎世界各地的企业采用OpenShell,让这些智能体能够在企业内部自主运行。
不同能力、不同任务、不同使用者,对应不同的权限需求。每次启动智能体,所需要的权限可能都不一样。
因此,权限配置、策略执行和监控,都必须动态完成。
我很高兴宣布,Anthropic与英伟达正在合作,将Claude智能体与OpenShell结合。网站上有一篇很好的介绍文章。
你可以使用OpenClaw、Hermes、OpenHands,也可以通过LangChain、Deep Agents构建自己的框架,甚至直接用Python编写。
这些智能体框架都可以运行在OpenShell提供的安全沙箱中。
接下来谈模型。
未来,我们不会只用一个模型处理所有工作,而是会根据任务选择最合适的模型,无论它是闭源、开放还是定制模型。
有些工作相对通用,通用人工智能就能做得很好。
但另一些工作包含大量专有知识和专业能力,而且你希望持续提升这些能力。
因此,未来每家公司都会同时使用闭源模型,以及自行定制的开放模型。
到今天演讲结束时,大家会发现,构建自己的AI并没有那么困难。
首先当然是模型。
我们一直致力于推动开放模型的发展,开拓新机会,让大家能够构建自己的定制AI。
Nemotron面向语言。
Cosmos是我们的世界基础模型,我们在这一领域处于前沿。
GR00T面向人形机器人。
Alpamayo面向自主导航。
Ising面向量子—经典混合计算。
Earth-2面向物理AI。
在这些不同领域,我们都提供模型,并持续投入研发。我们已经做了十年,也会长期做下去。
我们不仅开放模型,还提供相关数据,让你了解模型的数据来源,并提供复现所需的脚本。
因此,你得到的不只是开放权重,而是完整的方法、数据和复现路径。你能够知道模型从何而来,并建立对它的信任。
这些模型未必在所有领域都是最前沿的,尤其是在语言模型方面。
但通过定制,以及与生态伙伴合作,你可以将它们提升到自己所需领域的前沿水平,把专有数据转化为自主掌握的智能。
例如,AI21帮助Alice将Nemotron定制为超越相关前沿能力的模型。
Baseten帮助CodeRabbit使用自身数据微调Nemotron,实现前沿水平的能力。
Trajectory与Harvey也通过对Nemotron进行后训练,构建自己的前沿能力。
Scale与Skydance同样在做这样的事情。
例子还有很多。
核心在于,你可以从Nemotron这样优秀的开放模型出发,用自己的数据针对特定用例进行后训练,从而获得高度专业化的智能。
这是一条非常合理的路径,所需技术今天都已具备。
这里还有Palantir与坦帕综合医院的案例。
我们拥有丰富的合作伙伴生态,能够帮助大家。这些都是出色的公司,可以为世界各地的客户提供服务。
我如果只提一家,就会漏掉其他伙伴;如果全部列出来,又要花很长时间。我非常珍视所有这些合作伙伴。
总结一下:首先,让智能体框架运行在OpenShell安全沙箱中;其次,选择Nemotron等大语言模型。
但真正让普通智能体变成“超级智能体”的,是让它访问你公司的知识。
我们将这套能力称为智能体知识基础。
它由一组世界级模型和工具组成,帮助你处理公司的各种数据资产。
数据可能以非结构化形式存在于文档中,因此需要AI理解PDF和其他非结构化文件;也可能以结构化形式存在于数据库中。
我们提供必要的库和工具,帮助你从企业数据中提取含义、形成理解。
Nemotron Parse负责文档解析,表现位居相关排行榜前列。
Nemotron Embed将查询与向量数据库中的知识关联起来,同样具有领先表现。
Nemotron Rerank则处理检索到的多个来源和数据片段,根据与查询的相关程度重新排序。
Kumo可以利用结构化数据库预测可能发生的事情。
举例来说,你收到供应商通知,某些物料将出现短缺或交付延迟。这条信息很可能是一份非结构化文档。
而公司订单信息通常保存在SQL等结构化数据库中。
如果要预测哪些订单会受影响、哪些会缺货、延迟多久,可以使用Kumo。
接下来,为了寻找替代零件,你可以使用向量数据库检索,找到相关替代部件的工程文档。
这些模型、库和数据处理能力,共同构成知识基础,让AI能够利用你的专有数据和专有知识。
最后是工具,也就是完成专业工作所需要的工具。
英伟达一直在开发CUDA-X。
在AI成为主要话题之前,我们的大量讨论都围绕着如何加速模拟器、求解器、数据处理引擎,以及各种领域专用库展开。
这些工具用于各个科学领域的发现,也用于工程、研究、设计、建造和创意艺术。
它们的核心是CUDA-X库,而CUDA-X库本质上是算法。大家知道,算法是美的。
我们来看一段展示。
数学很美。
CUDA-X库是我们公司的核心资产。原因在于,当你构建AI助手时,无论它是实验室助手、研究助手,还是与你共同设计和创造的伙伴,最终让它真正有用、能够完成实际工作的,都是工具。
现在,我们拥有能够让智能体理解信息、推理、规划,并不断采取行动、使用工具直到完成任务的模型。
但最终,仍然离不开工具。
这些工具,我们已经开发了很多年。
刚才展示的右侧那类计算机,可以运行所有这些工具,无论是流体动力学、粒子物理、量子化学、数据处理,还是光线追踪。
与直接在CPU上运行相比,它可以将处理速度提高10倍、50倍,甚至100倍。
CUDA-X给智能体提供了完成专业工作的能力。看到其他人如何使用这些工具,非常令人兴奋。
这就是智能体背后的关键。
智能体最终需要使用工具。
软件编程是最早采用智能体的领域之一,在那里,编译器或Python往往就足以完成很多工作。
但未来,随着智能体承担越来越多实际任务,我们需要为它们提供更多工具。
下面是几个例子。
Lila Sciences正在开发实验室助手,使用英伟达的BioNeMo模型理解蛋白质和细胞,并在药物发现中设计蛋白质及化学分子,同时调用CUDA-X工具。
西门子正在构建工厂智能体,使用理解物理世界的Cosmos世界基础模型,以及CUDA-X工具。
达索系统则在开发虚拟伙伴,使用Nemotron语言模型和CUDA-X工具。
来看看它们如何工作。
视频旁白:
最聪明的科学家仍然需要实验室,最优秀的工程师仍然需要模拟器和求解器,AI智能体也是如此。
一个智能体由五个部分组成:
模型负责感知、推理和规划。
框架负责协调工作。
知识基础从公司的结构化和非结构化数据中提供上下文。
工具让智能体能够模拟、实验和采取行动。
NVIDIA OpenShell控制智能体可以访问和执行什么。
你可以从前沿闭源模型开始,也可以定制开放模型。借助NVIDIA Agent Toolkit,任何公司都能将自身知识和专业能力转化为定制超级智能体。
来看三个例子。
对于Lila Sciences,目标是设计一种针对B细胞淋巴瘤的疗法。
基于Nemotron构建的Lila Iris智能体,将这一目标转化为实验计划。
在计算干实验室中,Lila智能体使用NVIDIA BioNeMo Agent Toolkit,调用蛋白质设计和RNA优化模型,运行数百万次虚拟实验。
最有前景的候选方案进入Lila的AI科学工厂,由借助Omniverse和Cosmos开发的自主机器人及仪器进行制备和测试。
结果返回Iris,影响下一轮设计和实验,形成持续迭代的闭环。
在西门子埃尔朗根电子工厂,目标是让新产品投入生产。
Process Preparation X智能体使用Cosmos生成虚拟原型和合成数据,在生产开始前训练并验证检测模型。
基于NVIDIA工厂运营蓝图构建的Intelligence Center X智能体,根据订单、物料供应和产线配置,提出生产计划建议。
Digital Twin Composer利用Omniverse库,将物理仿真与实时工厂数据结合,在实际调整生产现场之前验证这些计划。
在达索系统平台上,一位工程师需要将大众Golf的车门设计适配到Tiguan车型。
Aura和Leo使用Nemotron理解和推理工程要求。
智能体框架协调各个专业子智能体,并在规划、设计和仿真过程中保留上下文。
Aura使用ENOVIA,根据车辆尺寸、重量限制和其他工程要求规划工作。
Leo设计智能体选择兼容的Golf车门设计,再使用CATIA修改形状,使其适配Tiguan。
Leo仿真智能体使用由CUDA-X加速的SIMULIA测试不同方案,发现了振动问题。
结果返回设计智能体进行优化,工程师审核改进后的设计,并选择最终方案。
不同的目标,不同的专业知识,相同的基础组成:开放模型、CUDA-X加速工具,以及OpenShell安全运行时,通过NVIDIA Agent Toolkit整合在一起。
黄仁勋:
很棒,对吧?
有人说,AI来了,软件和工具公司的时代就要结束了。
事实恰恰相反。
AI到来后,使用这些工具的用户将比以往任何时候都多。
每一家工具公司都将成为AI公司、智能体公司。它们不仅提供工具,还会提供经过专门优化、非常擅长使用这些工具的智能体。
Cadence、CrowdStrike、达索系统,以及其他许多企业软件公司,都在构建智能体。我们很高兴与它们合作。[原稿名单中另有一家公司名称不清。]
构建智能体并没有那么困难。它有五个组成部分:模型、框架、OpenShell安全运行时,以及最重要的知识和工具。
模型和框架都有开放和闭源版本,而知识与工具属于你,代表你的专业能力。
这些事情如今都已能够实现。稍后我还会展示更多,但在此之前,先谈谈物理AI。
物理AI是AI的下一波浪潮。
它能够理解物理世界,并对其进行推理。因为物理世界多样、复杂,存在极其丰富的长尾情况,AI需要理解这些情况,再使用合适的工具与物理世界互动。
一谈物理AI,大家往往想到机器人。
但我最喜欢的应用之一,其实是移动通信基站。
它不是用摄像头、扬声器或麦克风,而是通过无线电波感知世界,处理信息并进行推理,再利用波束成形与世界互动。
因此,通信是一种非常适合AI的技术。
AI将彻底改变电信网络,大幅提高频谱效率。
就像我们在光线追踪上所做的一样:大家看到的图形采用完整光线追踪,而在引入AI之后,与过去认为必要的计算量相比,效率出现了百万倍量级的变化。
我们将为电信网络带来巨大的频谱效率提升。
除此之外,还将改变这些通信站点。原稿所述西方地区约有10万个站点,构成约100吉瓦的分布式数据中心基础设施,未来将演变为分布式AI基础设施。
我们很高兴与欧洲众多公司合作。
经过近八年的研发,就在上周,英伟达与诺基亚合作,在T-Mobile网络上完成了首次商用通话。
现在,CUDA已经能够执行传统通信处理。在此基础上,我们就可以进一步叠加AI能力,推动新的变革。
另一个让我非常兴奋的物理AI应用,是机器人辅助放射治疗。
在治疗过程中,肿瘤形状可能变化,人体也会移动。这套自适应放疗系统必须感知环境变化,识别肿瘤位置,精确分割目标,并据此准确引导放射治疗。
本质上,这是一种机器人化治疗。
当然,大家最熟悉、近期最有望实现大规模应用的机器人或物理AI领域,是我们已经投入十多年的自动驾驶。
我们意识到,每一家汽车公司都希望自己的车辆能够加入出行服务车队。
今天已有Uber、Bolt、Grab、Lyft等平台。未来,自动驾驶出租车也会接入这些出行服务,而且不会只来自一个品牌。
但开发这样的系统,尤其是其软件,成本非常高。
因此,我们决定创建一个标准架构。
这套架构包括14个摄像头、9套雷达、3个激光雷达,以及一组超声波传感器。
这些传感器形成一个环绕车辆的感知系统,由双NVIDIA GPU系统提供自动驾驶计算能力。
我们将它发展为行业标准,如今正在被越来越多车型采用。
自动驾驶软件公司在其上开发能力,英伟达自己也是其中之一。这些自动驾驶出租车再接入出行服务平台,形成完整生态。
全球每年的出行里程约为1万亿英里。未来,其中相当一部分里程可能由自动驾驶出租车完成,按每英里1至2美元计算,这是一个巨大机会。
但市场非常分散。
通过建立Hyperion这样的标准架构,并与整个生态合作,我们就能形成一个巨大的虚拟车队,让各方都能接入。
今天,我很高兴宣布,又有四个品牌或车型系列加入:大众厢式车、捷豹路虎的新车型、沃尔沃车队,以及梅赛德斯-奔驰下一代车型。
它们将兼容Hyperion,并成为这一自动驾驶出行网络的一部分。
欢迎加入Hyperion。
下一个伟大产业,而且很可能规模极其庞大的产业,是人形机器人。
机器人之所以难做,一个重要原因是任务种类非常多。
如果针对每一种任务都开发一种特殊形态,就会把机器人产业分割成许多不同配置,难以形成推动技术进步的规模效应。
手机、个人电脑,以及英伟达NVLink 72之所以进步如此迅速,是因为标准化配置可以服务大量客户。
大量需求带来规模,规模又推动技术迭代,让产品更快、更好。
因此,我们需要尽可能标准化的机器人形态。
人形机器人未必适合所有任务,但很可能适合很多任务。因此,它可能成为出货量最大的机器人形态。
如果我们再为它开发能够快速学习的AI,那么即使中小企业没有专门的机器人团队,也不必从头编程,只需要向机器人演示要完成的工作。
机器人凭借通用能力和通用智能,就能快速学习和适应。
这很可能成为下一个重要技术平台。
我们正在与许多公司合作,其中不少来自欧洲。这是欧洲的重要机会。
欧洲在机电一体化、电子和机械系统的精度与工艺方面,拥有深厚积累。这里有大量制造能力极强的企业。
机器人将成为下一个大规模产业。许多公司已经参与进来,我们很高兴与大家合作。
构建物理AI系统,需要三类计算机。
第一类,就是我们一直在谈、大家也很熟悉的计算机,用来训练AI模型。
第二类,用来让AI学习技能。
你不能只是把AI编写出来,就让它进入物理世界随意尝试。学习应该先在数字孪生中进行。
我们创建了Omniverse数字孪生平台。
刚才看到的很多CUDA-X演示,都运行在数字孪生世界中。
Omniverse是一组可以接入各种平台和工具的库,包括西门子、达索系统、Cadence等公司的平台。它们共同构建数字孪生系统。
第三类,是部署在机器人上的计算机。
对于自动驾驶汽车和自动驾驶出租车,我们将相关平台称为Hyperion。
它包括计算机本身、功能安全系统、主动安全系统,以及专为物理AI安全设计的操作系统。
我们也需要为机器人提供同样完整的平台。
这样,当大家开始研究或开发机器人时,就不必从零拼装所有软件、计算系统、传感器和机械部件。仅仅完成这些准备工作,就可能耗费几年时间。
因此,我们决定打造一款参考机器人。
这就是英伟达与Agile Robots合作的Agile One。
这款参考机器人预计将在明年第一季度提供,出厂时已经完成组装,内置计算机,集成软件,开箱即可具备相当不错的能力。
它将成为一个很好的起点,推动机器人开发加速。
现在,让我们回到演讲开始的地方。
英伟达诞生于个人电脑革命之中。
1993年,我们成立时,PC革命正准备进入新的阶段;Windows 95随后让它进一步加速。
此后,我们发明了GPU,推动可编程着色和实时光线追踪发展,将CUDA加入计算模型,并帮助点燃现代AI革命。
四年前,我们开始思考:面对新的时代,能否重新定义个人电脑?
它不再只是你的工具,而是你的个人智能体、个人助手。你与它的互动,更像与一位帮助你工作的伙伴交流。
因此,这台计算机需要具备今天介绍的五个部分。
它需要模型,模型可以在本地运行,也可以在云端运行。
它需要智能体框架。
它需要OpenShell安全运行时。
它还需要访问个人电脑中的知识和工具。
好消息是,英伟达已经加速这些工具很多年。
只要我们创造一台同时支持OpenGL、DirectX和CUDA加速的计算机,英伟达过去开发的一切就都能够在其上运行。
这就是成果。
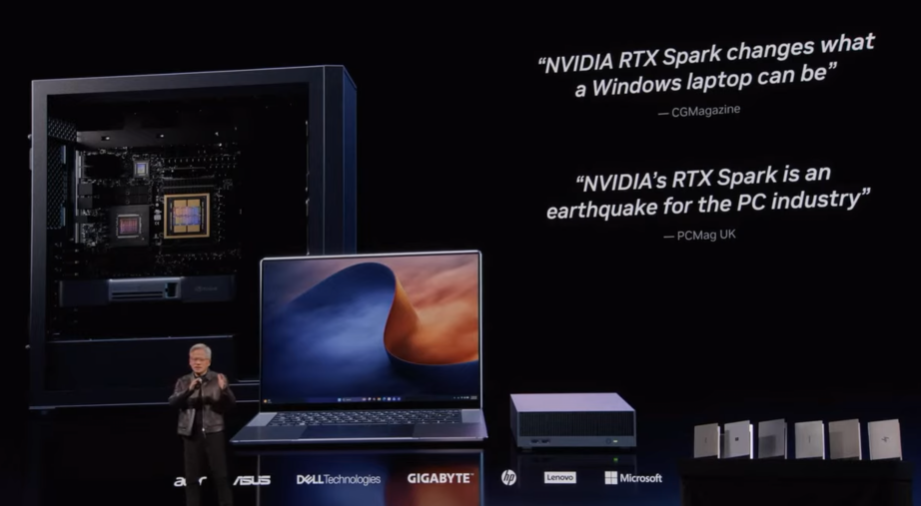
经过四年与微软的合作,我们打造了RTX Spark,这是一条全新的计算机产品线。
数千个工程人年的投入,凝结在其中。我们秘密研发了四年,创造了一颗名为N1X的芯片,最近与整个PC产业共同发布。
我们打造了台式机、笔记本电脑和工作站。
这台设备提供1 PFLOPS算力。
作个对比:2016年,我向当时还很小的OpenAI交付了一台拥有1 PFLOPS算力和128GB内存的计算机。
现在,这台小设备同样提供1 PFLOPS算力和128GB内存。
区别在于,我可以这样把它拿在手里,而当年的DGX-1需要两个人才能抬上楼。
这就是全新的RTX Spark PC。
如果你想要一台运行CATIA、达索系统其他软件,以及Autodesk、Adobe、Cadence和Synopsys工具的配套工作站,也可以选择运行Windows的DGX Station。
它提供20 PFLOPS算力和754GB内存。
此外,还有桌面版本。
相关产品正在推出,运行Windows的DGX Station预计将在今年年底上市。
现在,我已经讲了智能体的五个组成部分。接下来的问题是,怎么构建智能体?
如何让它运行在这些计算机上,或者运行在云端、企业本地环境中?
答案其实很简单。
构建智能体的方法,就是请一个智能体替你构建。
接下来,这段提示词将驱动一个应用。
大家将看到一个机器人应用演示。观看时请记住,这台个人电脑上运行着一个智能体,而整套演示涉及三类计算机:
第一类用于训练。
第二类运行数字孪生。
第三类将AI部署到机器人本身。
这里有两个核心概念:一是如何构建和运行智能体,以及能用它做什么;二是由三类计算机构成的物理AI计算模式。
我们来看演示。
视频旁白:
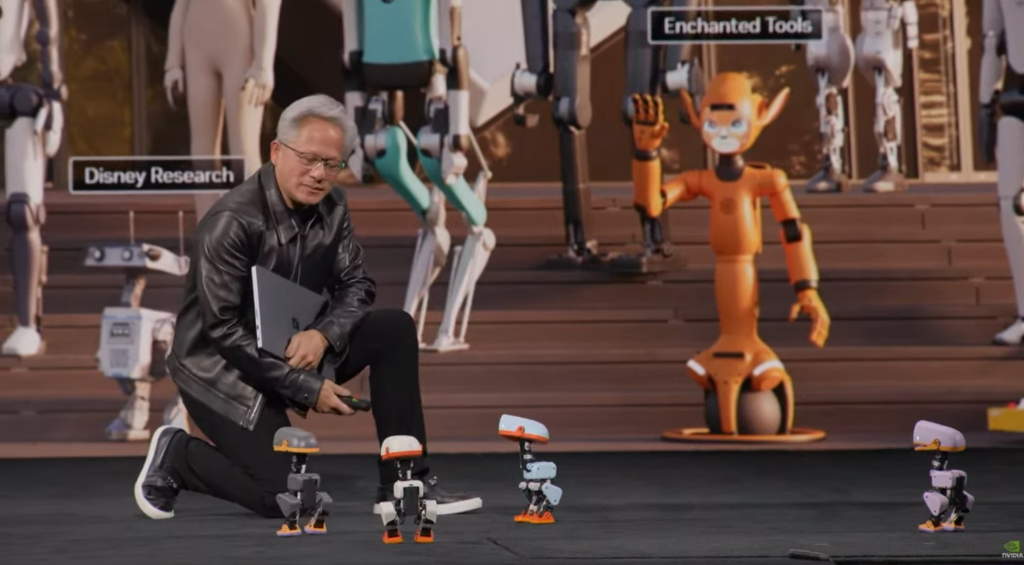
这是Hugging Face的机器人Micro Duck。
让我们使用NVIDIA RTX Spark,教它观察世界和行走。
我使用Hermes作为智能体框架,以Nemotron和OpenAI的GPT-6 Astra作为模型,并使用CUDA-X加速工具:FreeCAD、Blender、Isaac Sim、Newton物理引擎和Isaac Lab。
除非需要将大型工作负载扩展到云端,否则所有任务都在RTX Spark上运行。
首先,我描述训练场地,以及Micro Duck需要学会什么。
RTX Spark上的Hermes和Nemotron规划场地,列出所需的全部物体。
随后,Astra使用FreeCAD建立三维物体模型,用Blender赋予材质,再通过Omniverse仿真就绪库添加物理属性。
Astra在Isaac Sim中布置场景,为Micro Duck配置关节、执行器和连接结构,再利用Newton物理引擎模拟它的运动。
接下来开始训练。
云端的Isaac Lab让数千个Micro Duck同时训练。
每一次跌倒都是一次学习机会,推动控制策略不断改进。
Omniverse库模拟Micro Duck的摄像头,教它“看见”环境。
当感知与物理能力结合后,Micro Duck能够避开障碍、穿过狭窄空间,并适应周围环境。
我将训练策略下载到RTX Spark,使用Nemotron和Isaac Sim,通过多智能体编排对Micro Duck进行评估。
最后,将通过验证的策略部署到真实机器人上,它就可以开始行动了。
NVIDIA RTX Spark,让你直接在笔记本电脑上构建和运行AI智能体及其加速工具。
黄仁勋:
你们好!过来,给大家看看你们会走路。
你们还有摄像头。小心,别绊倒。
能坐下吗?现在站起来。休息一下,再站起来。
你们知道自己是在这里被创造出来的吗?
你们诞生于RTX Spark,在云端的大量英伟达超级计算机上接受训练,并在RTX Spark上的Omniverse数字孪生中学习技能。
是不是很神奇?
你们真可爱。你们的“父母”叫Pollen,对吧?Pollen Robotics。
听说大家太喜欢你们了,已经卖光了。
所有观看这段视频的朋友——可能会有两千万人——都可以去Pollen的网站看看,下一笔订单。
这家初创公司大概只有十个人,订单可能一下子就把他们淹没了。
每个人都应该有一只,你们太可爱了。
有一台RTX Spark,我们就能继续教你们新技能。
能翻个跟头吗?
太棒了!
那么,今天我们谈了什么?
我们谈到了欧洲建设自己的AI经济,而这一切从基础设施开始。
我们发布了新的DSX Pod系统,让建设AI工厂更加容易。
而这些AI工厂,不再只是运行模型。
[转向机器人。]
集中注意力,过来,坐下。
这些工厂运行的是完整的智能体。
智能体包含五个部分:
大语言模型负责感知、推理、规划和行动。
智能体框架相当于它的外骨骼,负责协调运行。
框架运行在OpenShell安全运行时中。
再赋予它访问知识和工具的能力。
这些智能体运行在我们的计算机上,而我们还在向下一代扩展,也就是物理AI。这就是你们这些小机器人的用武之地。
每个人都能构建智能体,欧洲每家公司都会成为AI公司,这一点毫无疑问。
欧洲将拥有蓬勃发展的AI经济。
33年来,这是一段不可思议的旅程。我们制作了一段很酷的视频,你们要一起看吗?
过来一点,我们让开舞台。全速前进!
视频主持人:
这样的演示之后,我们还能拿什么接着上场?
有一件事,能让现场更沸腾。
是什么?
你绝对想不到,GTC要变成欧洲歌唱大赛了!
黄仁勋:
感谢大家,感谢所有赞助商,也感谢33年来与我们一路合作的伙伴。
还有Micro Duck,我的新朋友们。
让我们一起建设欧洲的AI经济,让AI真正投入工作。
祝大家度过一场精彩的GTC!